ChatGPT accede ai contenuti del sito web per apprenderne il significato. In questo articolo vedremo come bloccare i tuoi contenuti dall’essere utilizzati come dati di formazione per l’AI.
C’è preoccupazione per la mancanza di un modo facile per scegliere se consentire o meno l’utilizzo dei propri contenuti per addestrare grandi modelli di linguaggio (LLM) come ChatGPT. C’è un modo per farlo, ma non è semplice e non è garantito che funzioni.
I grandi modelli di linguaggio (LLM) sono addestrati su dati provenienti da molteplici fonti. Molti di questi dataset sono open source e sono liberamente utilizzati per l’addestramento di IA.
Esempi di tipi di fonti utilizzati:
- Wikipedia;
- Registri giudiziari governativi;
- Libri;
- Email;
- Siti web crawlati.
In realtà, esistono portali e siti web che offrono dataset con enormi quantità di informazioni.
Uno dei portali è ospitato da Amazon, che offre migliaia di dataset nel Registro dei dati aperti su AWS.
Wikipedia elenca 28 portali per il download di dataset, tra cui il portale Google Dataset e Hugging Face per trovare migliaia di dataset.
ChatGPT si basa su GPT-3.5, noto anche come InstructGPT.
I dataset utilizzati per addestrare GPT-3.5 sono gli stessi utilizzati per GPT-3. La differenza principale tra i due è che GPT-3.5 utilizza una tecnica chiamata RLHF.
I cinque dataset utilizzati per addestrare GPT-3 (e GPT-3.5) sono descritti nella pagina 9 del paper di ricerca “Language Models are Few-Shot Learners” (PDF).
I dataset sono:
- Common Crawl (filtrato);
- WebText2;
- Books1;
- Books2;
- Wikipedia.
L’idea è che questi URL siano affidabili e contengano contenuti di qualità.
Il dataset originale WebText aveva circa 15 miliardi di token. WebText è stato utilizzato per addestrare GPT-2.
WebText2 è leggermente più grande, con 19 miliardi di token. WebText2 è stato utilizzato per addestrare GPT-3 e GPT-3.5.
Come bloccarlo
Uno dei dataset più comunemente utilizzati è il dataset Common Crawl creato da un’organizzazione no-profit chiamata Common Crawl.
I dati di Common Crawl provengono da un bot che attraversa l’intero Internet.
I dati vengono scaricati dalle organizzazioni che desiderano utilizzarli e poi puliti da siti di spam, ecc.
Il nome del bot di Common Crawl è CCBot.
CCBot rispetta il protocollo robots.txt, quindi è possibile bloccare Common Crawl con Robots.txt e impedire che i dati del tuo sito web siano inclusi in un altro dataset.
Tuttavia, se il tuo sito è già stato scansionato, è probabile che sia già incluso in più dataset.
Tuttavia, bloccando Common Crawl, è possibile scegliere di non includere i contenuti del tuo sito web in nuovi dataset provenienti da dataset Common Crawl più recenti.
La stringa del user agent di CCBot è:
CCBot/2.0
Aggiungi il seguente codice al tuo file robots.txt per bloccare il bot di Common Crawl:
User-agent: CCBot
Disallow: /
CCBot rispetta anche le direttive del tag meta robots nofollow.
Utilizza questo nel tuo tag meta robots:
<meta name=”CCBot” content=”nofollow”>.
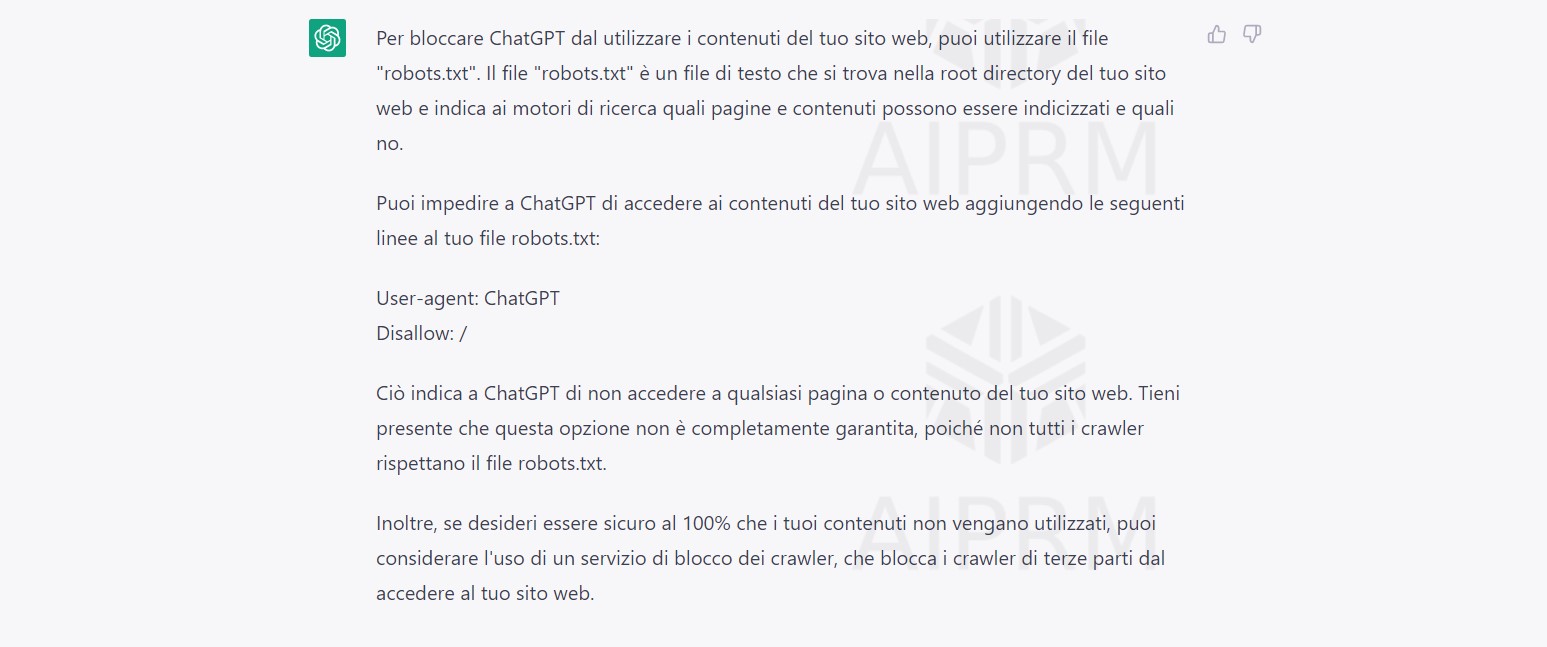
ChatGPT consiglia inoltre di programma direttamente il tool:
Per bloccare ChatGPT dal utilizzare i contenuti del tuo sito web, puoi utilizzare il file “robots.txt”. Il file “robots.txt” è un file di testo che si trova nella root directory del tuo sito web e indica ai motori di ricerca quali pagine e contenuti possono essere indicizzati e quali no.
Puoi impedire a ChatGPT di accedere ai contenuti del tuo sito web aggiungendo le seguenti linee al tuo file robots.txt:
User-agent: ChatGPT
Disallow: /
Ciò indica a ChatGPT di non accedere a qualsiasi pagina o contenuto del tuo sito web. Tieni presente che questa opzione non è completamente garantita, poiché non tutti i crawler rispettano il file robots.txt.
Clicca in basso se vuoi maggiori informazioni sul nostro servizio SEO e modificare il tuo file robots correttamente, non solo per quanto concerne ChatGPT: